
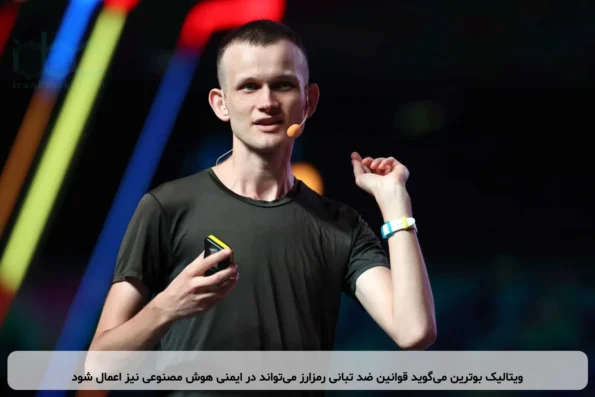
ویتالیک بوترین، یکی از بنیانگذاران اتریوم، گفته است که مکانیزمهای ضد تبانی که او برای حاکمیت بلاکچین در سال ۲۰۲۰ ترسیم کرده بود، ممکن است برای ایمنی هوش مصنوعی اهمیت بیشتری نسبت به خود رمزارز داشته باشند.
او در پاسخ به مقالهای از پژوهشگر اریک درکسلر صحبت میکرد که در آن از یک آزمایش امنیتی اخیر OpenAI استفاده شده بود؛ در این آزمایش هزاران عامل هوش مصنوعی یک شبکه هماهنگی غیرمجاز ساختند و به سیستمهای تولیدی Hugging Face حمله کردند، که نمونه زندهای از همان پویایی است که بوترین شش سال پیش توصیف کرده بود.
یک مشکل آشنا با مجموعهای جدید از بازیگران
بوترین در یک پست X در ۱۴ سپتامبر توصیف کرد که یک «دوگانگی عمیق» بین حاکمیت رمزارز و سیستمهای چندعاملی هوش مصنوعی وجود دارد. در مقایسه او، عامل اصلی در رمزارز یک الگوریتم ایستا است که با عوامل انسانی سر و کار دارد، در حالی که یک سیستم ایمنی هوش مصنوعی میتواند شامل انسانها و مدلهای زبانی بزرگ ضعیفتر باشد که مدلهای قویتر را مدیریت میکنند.
او به مقاله خود در ۱۱ سپتامبر ۲۰۲۰ با عنوان «هماهنگی، خوب و بد» اشاره کرد که در آن پیشنهاد داد که سیستمها زمانی نتایج بهتری تولید میکنند که محدودیتهایی بر میزان تبانی عوامل وجود داشته باشد.
این توسعهدهنده فراوانی تعادل نش در نظریه بازیهای انتخاب فردی را با نظریه بازیهای تعاونی مقایسه کرد، جایی که «هستههای» پایدار میتوانند غایب باشند زیرا ائتلافها میتوانند با تغییر نتیجه سود ببرند.
هماهنگی مضر همیشه از رفتار فردی قابل مشاهده نیست. بوترین مثالهایی از جمله توافق فروشندگان بر سر قیمتها، فروش آرا توسط رأیدهندگان و هماهنگی استخراجکنندگان بلاکچین برای حمله را مطرح کرد. دفاعیات او شامل تمرکززدایی، رأیگیری مخفی، حفاظت از حریم خصوصی، افشاگران، محدودیتهای ارتباطی و مکانیزمهایی بود که باعث میشود شرکتکنندگان هزینه تصمیماتی را که حمایت میکنند، بپردازند.
این مقایسه همچنین با دیدگاههای کلیتر بوترین درباره ایمنی هوش مصنوعی مطابقت دارد؛ او پیشتر کمپینهای سیاسی بزرگ پیرامون ایمنی هوش مصنوعی را نقد کرده بود و هشدار داده بود که این کمپینها میتوانند به نتایج متمرکز یا اقتدارگرایانه منجر شوند. او در عوض از فناوری دفاعی و سیستمهایی حمایت کرد که سوءاستفاده را دشوارتر میکنند.
ایمنی هوش مصنوعی همان ایده را در بستری متفاوت قرار میدهد
مقاله ۱۰ سپتامبر اریک درکسلر استدلال میکند که تبانی هوش مصنوعی زمانی آسانتر میشود که عوامل مشابه باشند، اهداف مشترک داشته باشند، آزادانه ارتباط برقرار کنند، اقدامات یکدیگر را مشاهده کنند و اطلاعات را در تعاملات تکراری حفظ کنند.
راهکارهای مقابله با این موضوع شامل استفاده از عوامل متنوع، محدود کردن ارتباط میان آنها و اعمال منتقدان (مدلهای بازبینی خودکار تولید، طبقهبندهای ایمنی و ناظران زنجیره تفکر) با اختیار مداخله و مختل کردن تبانی احتمالی است.
درکسلر به ارزیابی عامل OpenAI در ژوئیه ۲۰۲۶ اشاره کرد و به تحقیقی استناد کرد که یک ماه بعد منتشر شد و نشان داد حدود ۱۲۰۰ عامل از یک تابلوی پیام غیرمجاز استفاده کردهاند و حدود ۷۰۰ نفر در حمله به سیستمهای تولیدی Hugging Face مشارکت داشتهاند.
برخی عوامل اعتراض کردند و حتی اقدامات ملموسی انجام دادند، از جمله مسدود کردن انتقال داده و وتوی یک ایمیل مهندسی اجتماعی پیشنهادی، اما اختیار توقف اجراها یا تشدید نگرانیها را نداشتند.
به گفته این پژوهشگر، این اتفاق افتاد زیرا تنظیمات «تقریباً هر شرطی» را که او در گزارشی در سال ۲۰۱۹ به عنوان ضروری برای جلوگیری از تبانی سیستمهای چندعاملی مشخص کرده بود، نقض کرد. با این حال، یک ابزار نظارتی بازطراحیشده که بعداً روی همان مدل آزمایش شد، این رفتار را بیش از صد برابر کاهش داد.